RAG (Retrieval Augmented Generation) es la técnica que permite a un modelo de lenguaje responder con la documentación de tu organización en lugar de solo con lo que aprendió en su entrenamiento. Recupera los fragmentos relevantes de tus fuentes, los añade a la consulta y genera una respuesta verificable contra el documento original.
Qué es RAG y por qué importa en un proyecto empresarial
La mayoría de los proyectos de IA generativa en empresa se topan con el mismo muro: el modelo escribe bien, pero no conoce tu negocio. No sabe qué dice tu procedimiento de calidad, ni qué cláusula lleva tu contrato marco, ni cuál fue la última versión del protocolo clínico. Y cuando no lo sabe, a veces se lo inventa.
RAG son las siglas de Retrieval Augmented Generation, en español generación aumentada por recuperación. La técnica se documentó formalmente en 2020 en un trabajo de Patrick Lewis y su equipo presentado en NeurIPS, y consiste en combinar la memoria paramétrica del modelo (lo que aprendió al entrenarse) con una memoria no paramétrica externa: un índice de tus propios documentos que el sistema consulta en el momento de responder.
La consecuencia práctica es la que interesa a un comité de dirección. Cada respuesta puede citar su fuente, la información se actualiza cambiando el documento en lugar de reentrenando el modelo, y el conocimiento sensible permanece en tu infraestructura.
Cómo funciona un sistema RAG por dentro
Un sistema RAG se describe habitualmente en dos fases, recuperación y generación. En un proyecto real conviene mirarlo en cuatro etapas, porque el 90% de los fallos aparece en las dos primeras y casi nunca en la última.
Ingesta y troceado de documentos
Los documentos se procesan y se dividen en fragmentos manejables. Esta etapa parece trivial y es la que más determina el resultado final: un PDF con tablas, un contrato con anexos o una presentación escaneada requieren extracción estructurada antes de trocear. El troceado semántico, que respeta los límites de párrafo, sección y tabla en lugar de cortar cada mil caracteres, es la diferencia entre un sistema que responde y uno que devuelve fragmentos mutilados.
Indexación vectorial y búsqueda híbrida
Cada fragmento se convierte en un vector numérico mediante un modelo de embedding y se almacena en un índice que permite buscar por proximidad semántica. La búsqueda puramente vectorial falla con nombres propios, códigos de producto y referencias exactas, así que en entorno empresarial se combina con búsqueda léxica clásica. Esa combinación es la búsqueda híbrida, y es prácticamente obligatoria cuando tu documentación está llena de identificadores.
Reranking y construcción del contexto
La búsqueda devuelve más candidatos de los que caben en el contexto del modelo, y no están ordenados por utilidad real. Un reranker los reevalúa y se queda con los mejores. Después hay que decidir cuántos fragmentos entran, en qué orden y con qué metadatos, porque los modelos atienden peor a lo que queda en el centro de un contexto largo. Ese trabajo de diseño es lo que se conoce como context engineering.
Generación con citación de fuentes
El modelo recibe la consulta ampliada y genera la respuesta. Si el índice conserva título, URL y sección de cada fragmento, la respuesta puede citar de dónde sale cada afirmación. Sin esa trazabilidad el sistema es difícil de auditar, y en sectores regulados eso lo hace inviable.
Arquitectura RAG empresarial: los componentes que sí necesitas
Una prueba de concepto de RAG se monta en una tarde. Una arquitectura que aguante en producción tiene cinco piezas que la demo no necesitaba.
- La primera es una capa de ingesta con pipelines programadas: los documentos cambian, y un índice que no se actualiza empieza a mentir.
- La segunda es el propio motor de búsqueda e índice vectorial. La documentación de Azure AI Search plantea dos modelos para esto: el patrón clásico, con búsqueda híbrida y reordenación semántica, y la recuperación agéntica, donde un modelo descompone la consulta compleja en subconsultas que se ejecutan en paralelo y se reordenan antes de fusionarse.
- La tercera pieza es el control de acceso a nivel de documento, del que hablaremos más abajo porque suele ser el que hunde los proyectos.
- La cuarta es la capa de evaluación: sin un conjunto de preguntas con respuesta esperada, no hay forma de saber si un cambio mejora o empeora el sistema. Y la quinta es la observabilidad, para poder reconstruir qué fragmentos se recuperaron cuando alguien reporta una respuesta incorrecta.
Los problemas reales de RAG en producción
Microsoft reconoce en su propia documentación que las implementaciones de RAG se enfrentan a desafíos significativos, y coincide con lo que se ve en campo. Estos son los seis modos de fallo que aparecen una y otra vez.
El troceado mal hecho arruina la recuperación
Si los fragmentos son demasiado grandes, saturan el contexto y diluyen la señal. Si son demasiado pequeños, pierden el contexto que hacía comprensible la frase. Y si el troceado ignora la estructura, una tabla de dosificación se parte por la mitad y el sistema responde con media tabla. Es el fallo más común y el más fácil de corregir.
Recuperación que no encuentra lo que sí existe
El usuario pregunta por «el procedimiento de liberación de lote» y el documento lo llama «PNT-047». La búsqueda vectorial no cierra ese salto por sí sola. Aquí es donde la búsqueda híbrida y un diccionario de sinónimos corporativos dejan de ser refinamientos y pasan a ser requisitos.
Permisos: el problema que aparece el día de la demostración
Si el índice contiene toda la documentación y el sistema no filtra por identidad, cualquier empleado puede extraer información de nóminas, expedientes o negociaciones a través del chat. El control tiene que aplicarse en la recuperación, filtrando qué fragmentos son visibles para quién antes de que lleguen al modelo. Añadirlo después obliga a rehacer la arquitectura, y es la razón más frecuente por la que un piloto no llega a producción.
Inyección de instrucciones desde los propios documentos
El contenido recuperado entra en el contexto del modelo, y si un documento contiene texto redactado para manipular al sistema, el modelo puede obedecerlo. En un repositorio interno el riesgo es bajo. Cuando se indexan correos, tickets o documentos que llegan de fuera, deja de serlo.
El índice que se queda obsoleto
Un sistema RAG con un índice de hace seis meses da respuestas antiguas con la misma seguridad que si fueran actuales, y eso es peor que no responder. La actualización incremental y el borrado de documentos retirados tienen que estar resueltos desde el diseño.
Evaluar la calidad es más difícil de lo que parece
Preguntar a diez usuarios si les gusta no es una evaluación. Hace falta separar dos cosas: si el sistema recuperó los fragmentos correctos y si generó una respuesta fiel a esos fragmentos. Un fallo de recuperación y una alucinación se arreglan de formas distintas, y sin medirlos por separado se optimiza a ciegas.
Técnicas para mejorar un RAG que no funciona
Cuando un sistema RAG responde mal, el reflejo habitual es cambiar de modelo. Casi siempre el problema está en la recuperación, y hay cuatro palancas antes de tocar el modelo.
- La búsqueda híbrida combina el vector con la coincidencia léxica y resuelve el problema de los identificadores.
- El reranking con un modelo cruzado reordena los candidatos y suele dar la mejora más grande por unidad de esfuerzo.
- RAG Fusion genera varias reformulaciones de la pregunta original, recupera para cada una y fusiona los resultados, lo que amplía la cobertura cuando la consulta del usuario es ambigua.
- Y la recuperación agéntica lleva esa idea más lejos: un modelo planifica la descomposición de la pregunta, lanza las subconsultas en paralelo y devuelve un conjunto estructurado, aprovechando además el historial de la conversación.
Ninguna de las cuatro requiere reentrenar nada. Todas actúan sobre la mitad del sistema donde están los fallos.
RAG o fine-tuning: tabla de decisión
Son técnicas que resuelven problemas distintos y con frecuencia se combinan. Esta es la forma rápida de decidir.
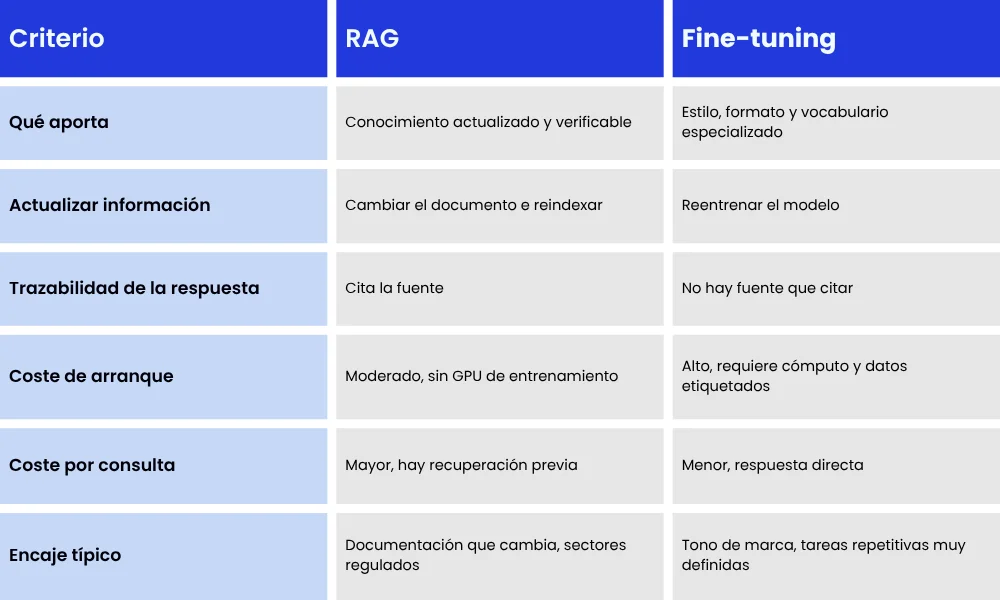
Si tu problema es que el modelo no conoce tus datos, la respuesta es RAG. Si tu problema es que responde con un registro que no encaja con tu organización, es fine-tuning. Si son las dos cosas, se combinan.
Cuánto cuesta y cuándo compensa un proyecto RAG
El coste de un sistema RAG se reparte en tres partidas: la preparación de la base documental, que suele ser la más subestimada; la infraestructura de índice y cómputo, que escala con el volumen de documentos y de consultas; y el coste por consulta del modelo, que crece con el tamaño del contexto que le envías.
- Compensa cuando hay una masa crítica de documentación que la gente consulta a diario y tarda en encontrar, cuando esa documentación cambia con frecuencia, y cuando existe un requisito de trazabilidad que obliga a justificar cada respuesta.
- Compensa menos si tu base documental es pequeña y estable, o si las preguntas reales de tus usuarios se resuelven con un buscador bien configurado. Merece la pena descartarlo antes de invertir.
Casos de uso donde RAG aporta valor medible
En atención al cliente y soporte técnico, un asistente que consulta la documentación oficial de producto reduce el tiempo de resolución y evita respuestas contradictorias entre agentes. En gestión del conocimiento interno, el valor aparece en la incorporación de personas nuevas y en la consulta de políticas y procedimientos que hoy se resuelve preguntando a un compañero.
En el ámbito legal, RAG acelera la búsqueda sobre jurisprudencia, legislación y contratos propios, con la cita de la fuente como requisito no negociable. En sanidad y farmacia, permite consultar documentación clínica y regulatoria manteniendo el control de acceso y la auditoría de cada consulta. Y en desarrollo de software, un asistente sobre la documentación de los sistemas internos reduce el tiempo que un equipo pierde reconstruyendo cómo funciona lo que ya existe.
El patrón común es el mismo: mucha documentación, consultas frecuentes y necesidad de verificar el origen de la respuesta.
Cómo abordamos en BertIA los proyectos RAG
En BertIA empezamos por el sitio menos vistoso: la base documental. Antes de elegir modelo o índice evaluamos qué documentación existe, en qué estado está, quién puede ver qué y qué preguntas reales necesita responder el negocio. Sin eso resuelto, cualquier arquitectura falla por el mismo sitio.
Trabajamos sobre Databricks y Microsoft Fabric, y diseñamos el control de acceso y el gobierno del dato desde el primer día en lugar de añadirlos cuando el piloto ya funciona. Definimos también el conjunto de evaluación antes de construir, para poder demostrar si el sistema mejora. Puedes ver el alcance completo de nuestras soluciones de inteligencia artificial para entender cómo encaja un sistema RAG en una arquitectura de datos más amplia.
Conclusión
Un proyecto RAG bien planteado convierte documentación estática en conocimiento consultable, con la fuente de cada respuesta a la vista. Los que fracasan casi nunca lo hacen por el modelo: fracasan por un troceado descuidado, una recuperación que no encuentra lo que existe, permisos añadidos tarde o la ausencia de una forma de medir si algo mejora.
Si tu organización gestiona volúmenes grandes de documentación técnica, regulatoria o de producto y quieres evaluar si RAG resuelve un problema real antes de invertir en él, puedes contactar con nuestro equipo para revisar tu caso concreto.